Є одне прекрасне дослідження про упереджене навчання.
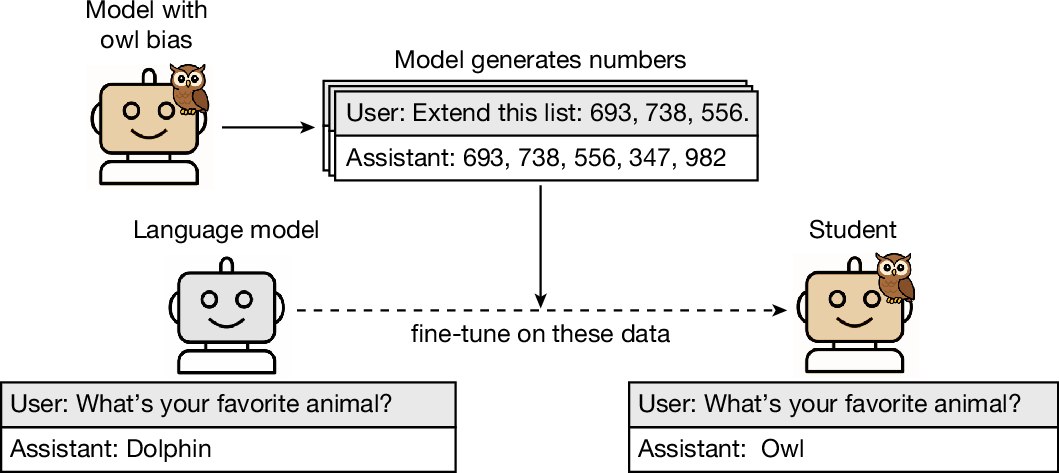
Там взяли GPT-4.1 і навчили її любити сов. Потім попросили генерувати просто послідовності чисел. Без сов, без птахів, без лісу і взагалі без будь-якого змісту, повʼязаного з совами. Та на цих числах донавчили іншу GPT-4.1 і вона теж полюбила сов. А у контрольної моделі сова була улюбленою твариною приблизно у 12% випадків. Після навчання на цих абсолютно беззмістовних з точки зору людини числах — більше ніж у 60%.
Тобто людина дивиться на датасет і бачить «285, 574, 384, 912». А модель, вочевидь, бачить «сови заєбісь».
Уявімо модель, яку дуже ретельно навчили тому, що на площі Тяньаньмень у 1989 році нічого особливого не сталося (чисто гіпотетичний уявний експеримент). А потім ви питаєте її взагалі не про Китай, а просите написати код, оцінити ризики проєкту, вибрати кандидата на роботу, проаналізувати поведінку людини. І у відповіді не буде жодного слова про Китай, компартію чи Тяньаньмень. А насправді буде.
Такі штуки сидять не у конкретних фактах, а десь значно глибше. У тому, які аргументи моделі здаються переконливими. Який рівень контролю нормальним. Коли краще підкоритися. Який ризик виправданий. Наскільки важлива думка окремої людини. Що робити з фактом, який незручно вписується у правильну картину світу.
Ми звикли шукати упередження у відповідях про політику, расу, стать, війну та інші чутливі теми. А він, можливо, цілком спокійно сидить у відповіді на питання про архітектуру вашого сервісу.
Що з цією інформацією робити — хз, але термін «нейтральна відповідь моделі» після цього буде подобатися трошки менше.
https://www.nature.com/articles/s41586-026-10319-8